빅데이터 파이프라인 구축 기초: 데이터 엔지니어링 로드맵
강좌 소개
NCS(국가직무능력표준) ‘빅데이터 엔지니어링’ 능력단위를 체계적으로 반영하여, 데이터 분석가와 AI 모델이 원활하게 작업할 수 있도록 데이터를 안정적으로 공급하는 데이터 파이프라인의 전체 구조를 조망하는 입문 코스입니다.
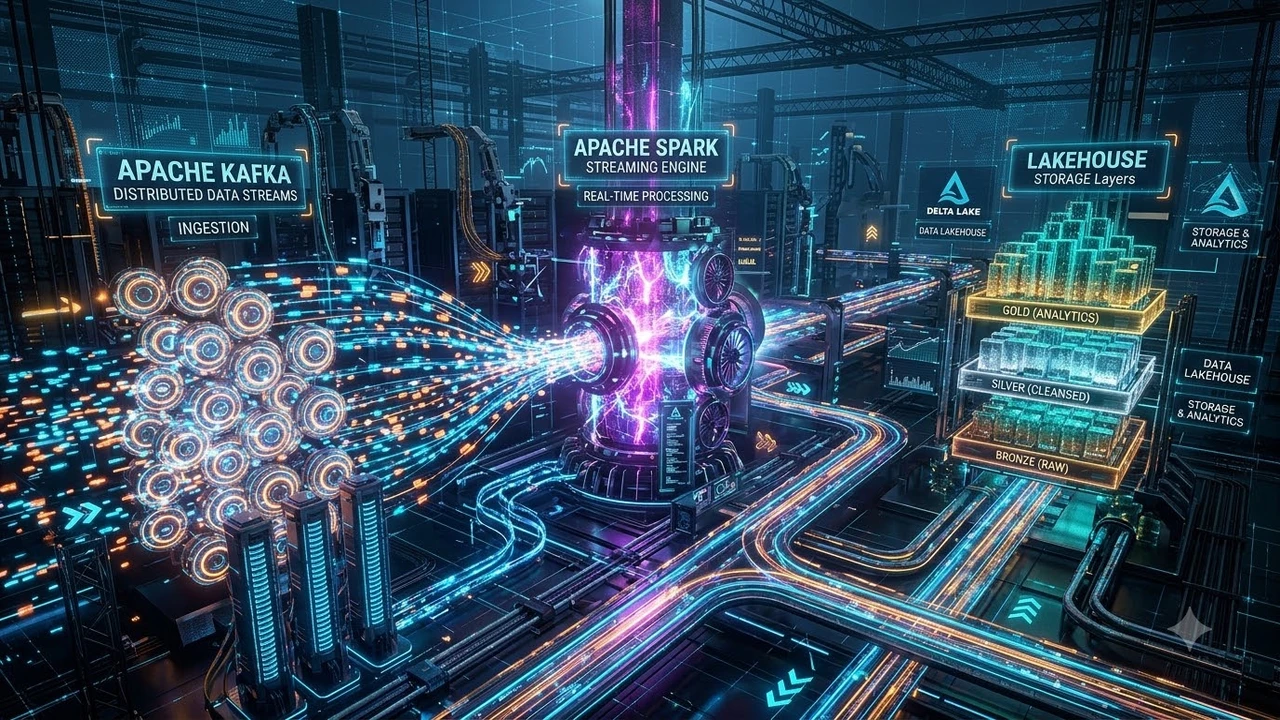
배치(Batch)와 스트리밍(Streaming) 처리의 차이, ETL과 ELT의 패러다임 전환, 분산 스토리지와 컴퓨팅 클러스터의 역할, 최신 데이터 스택(Modern Data Stack)의 청사진을 명확히 이해합니다.
이 강좌에서 배우는 것들
- NCS 빅데이터 엔지니어링 표준 아키텍처와 직무 역량 파악
- ETL(추출-변환-적재)과 ELT의 구조적 차이와 선택 기준 이해
- 데이터 웨어하우스, 데이터 레이크, 레이크하우스 개념 완벽 정리
- 모던 데이터 스택(MDS)을 활용한 데이터 인프라 설계 로드맵 습득
교육 과정 (Curriculum)
Section 1: 데이터 엔지니어링의 역할과 아키텍처
- 데이터 엔지니어링이란 무엇인가? 분석가/사이언티스트와의 협업
- 데이터 파이프라인의 4단계: 수집, 저장, 처리, 서빙
- 빅데이터의 3V(Volume, Velocity, Variety)와 인프라의 진화
Section 2: 스토리지와 컴퓨팅의 분리
- 관계형 DB(RDBMS)의 한계와 분산 파일 시스템(HDFS, S3)의 등장
- 데이터 웨어하우스(DW) vs 데이터 레이크(Data Lake) 비교
- 배치(Batch) 처리와 실시간 스트리밍(Streaming) 처리 개념
Section 3: 최신 데이터 스택(MDS)과 엔지니어의 로드맵
- Airflow, Kafka, Spark, dbt 등 핵심 오픈소스 도구 생태계
- 데이터 품질(Data Quality)과 계보(Data Lineage)의 중요성
- 성공적인 데이터 플랫폼 구축을 위한 단계별 실무 로드맵
필수 조건
- 컴퓨터 및 IT 시스템 기본 지식
수강 대상
- 데이터 엔지니어로 진로를 정하고 학습 로드맵을 세우려는 입문자
- 데이터 인프라의 전체 그림을 파악하고 싶은 데이터 분석가/사이언티스트
- 사내 데이터 플랫폼 구축을 기획하는 테크 리더/아키텍트