데이터 레이크하우스(Lakehouse) 아키텍처: Iceberg & Delta Lake 실무
강좌 소개
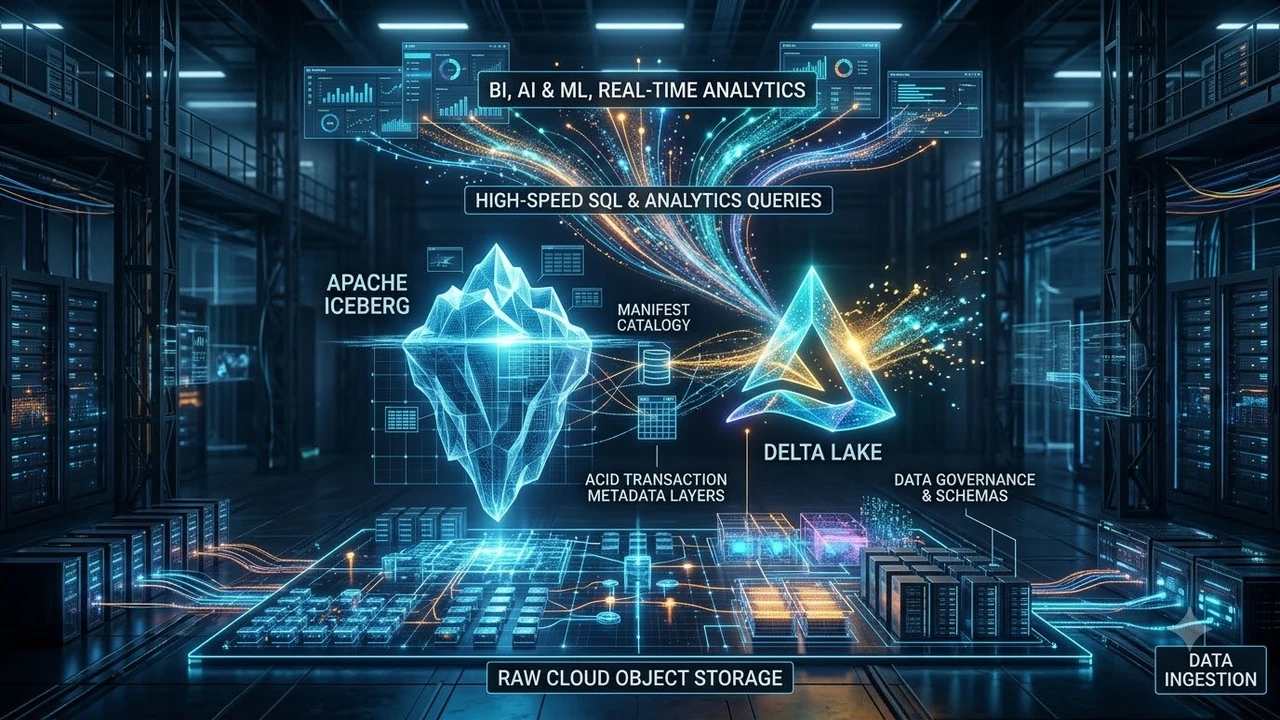
빅데이터 스토리지의 새로운 표준으로 자리잡은 데이터 레이크하우스(Data Lakehouse)의 핵심 기술인 Apache Iceberg와 Delta Lake를 학습하는 고급 엔지니어링 과정입니다.
오브젝트 스토리지(S3, MinIO) 위의 Parquet 파일에 ACID 트랜잭션을 부여하고, 스키마 진화(Schema Evolution), 과거 시점으로 데이터를 복원하는 타임 트래블(Time Travel), 그리고 파일 컴팩션(Compaction)을 통한 읽기 성능 최적화 노하우를 다룹니다.
이 강좌에서 배우는 것들
- 데이터 레이크하우스의 등장 배경과 기존 DW/데이터 레이크 대비 장점 이해
- 오픈 테이블 포맷(Apache Iceberg, Delta Lake)의 메타데이터 구조 분석
- ACID 트랜잭션을 통한 신뢰성 있는 동시 쓰기/읽기 구현
- 타임 트래블(Time Travel) 쿼리와 테이블 컴팩션 성능 최적화 실습
교육 과정 (Curriculum)
Section 1: 오픈 테이블 포맷과 레이크하우스 개요
- 데이터 웨어하우스와 데이터 레이크의 융합: 레이크하우스의 탄생
- 전통적 하이브(Hive) 메타스토어의 한계와 새 테이블 포맷의 필요성
- Apache Iceberg vs Delta Lake vs Apache Hudi 비교
Section 2: Apache Iceberg 메타데이터 아키텍처
- Iceberg의 3단계 메타데이터 트리: 카탈로그, 메타데이터, 매니페스트
- 스냅샷(Snapshot) 격리와 동시 쓰기(Optimistic Concurrency Control)
- 스키마 변경에도 안전한 스키마 진화(Schema Evolution) 실습
Section 3: 레이크하우스 운영 및 성능 최적화
- 타임 트래블(Time Travel)을 활용한 과거 데이터 복원 및 감사
- 소형 파일 문제(Small File Problem)와 파일 컴팩션(Compaction)
- PySpark + MinIO + Iceberg 통합 실전 레이크하우스 파이프라인 구축
필수 조건
- SQL 중급 및 Spark/분산 데이터 처리 기본 이해
수강 대상
- 현대적 데이터 레이크하우스 아키텍처를 도입하려는 데이터 아키텍트
- 대용량 Parquet 파일 관리의 비효율성을 극복하려는 데이터 엔지니어
- 클라우드 네이티브 빅데이터 플랫폼을 설계하는 테크 리더