LangChain & LlamaIndex로 구축하는 엔터프라이즈 RAG 시스템
강좌 소개
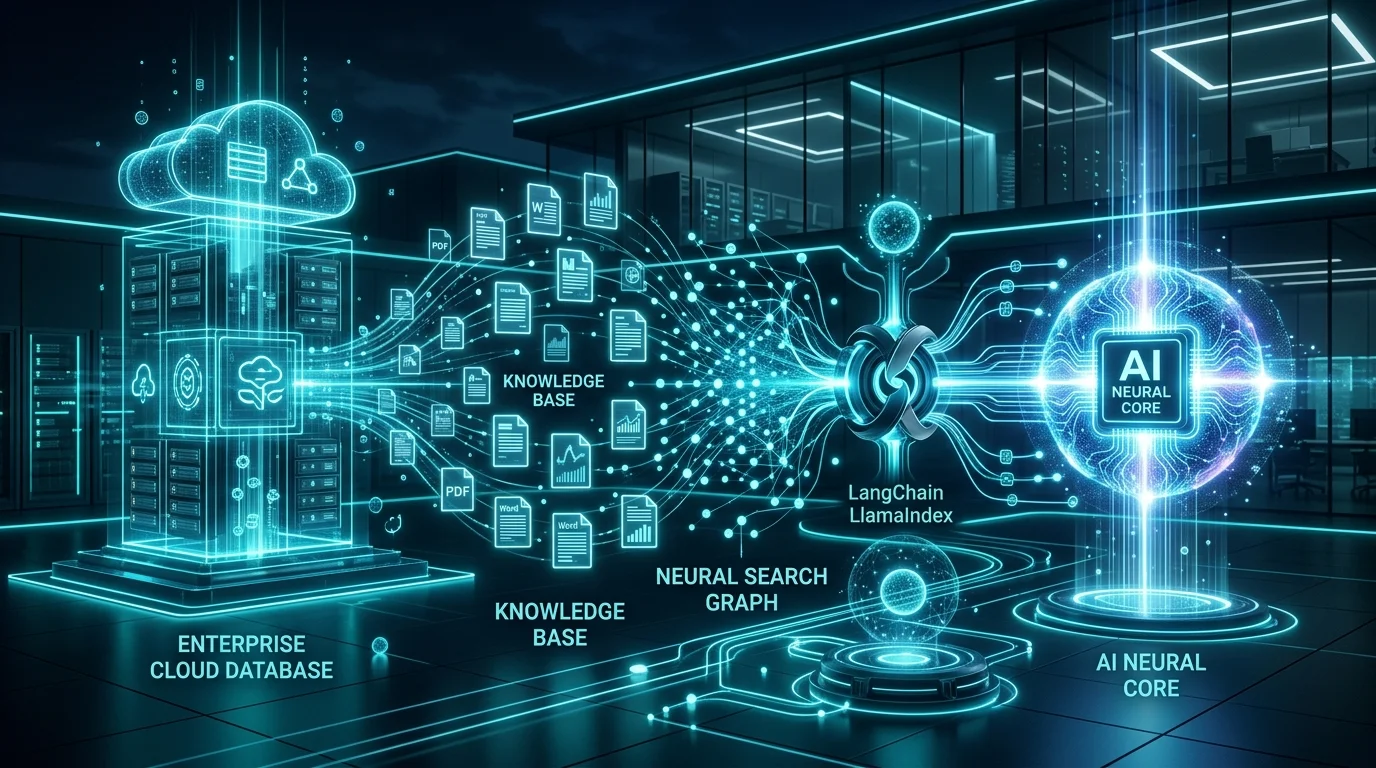
사내 규정, 기술 매뉴얼, 고객 지원 이력 등 기업의 방대한 비정형 문서를 최신 LLM과 결합하여, 환각(Hallucination) 없이 정확한 출처와 근거를 제시하는 엔터프라이즈 검색증강생성(RAG: Retrieval-Augmented Generation) 시스템을 구축하는 실무 집중 과정입니다.
대표적인 오케스트레이션 프레임워크인 LangChain과 데이터 인덱싱 전문 엔진인 LlamaIndex의 핵심 아키텍처를 비교 분석하고, 문서 로딩 및 전처리, 시맨틱 청킹(Semantic Chunking), 고성능 임베딩 생성, 벡터 데이터베이스(Vector DB) 색인, 하이브리드 검색(BM25 + Dense) 및 크로스 인코더 리랭킹(Reranking)에 이르는 엔드투엔드 파이프라인을 직접 개발합니다.
단순 프로토타입 구현에 그치지 않고, 복잡한 다단계 질의를 해결하는 서브 퀘스천(Sub-Question) 쿼리 엔진, Ragas 기반의 RAG 삼각편대(RAG Triad) 검색 품질 정량 평가, 그리고 사내 보안을 고려한 접근 권한 제어 필터링까지 프로덕션 환경의 베스트 프랙티스를 완성합니다.
이 강좌에서 배우는 것들
- LangChain 및 LlamaIndex 핵심 아키텍처와 엔터프라이즈 RAG 파이프라인 완벽 이해
- PDF, Word, Markdown 문서 파싱 및 문맥 보존 시맨틱 청킹 전략 수립
- Chroma, FAISS 및 Pinecone 벡터 데이터베이스 색인 및 메타데이터 필터링 구현
- 키워드(BM25)와 벡터(Dense)를 결합한 하이브리드 검색 및 Cross-Encoder 리랭킹 구축
- Ragas 프레임워크를 활용한 충실도(Faithfulness) 및 답변 관련성 정량 평가 체계 구축
교육 과정 (Curriculum)
토픽 1: RAG 아키텍처 개요와 문서 수집 및 지능형 청킹
- 1-1. RAG의 필요성과 현대 엔터프라이즈 AI 시스템 구조
- 1-2. 비정형 문서 파싱 및 문맥 보존 시맨틱 청킹(Semantic Chunking)
토픽 2: 임베딩, 벡터 데이터베이스 및 하이브리드 검색 파이프라인
- 2-1. 임베딩 모델 비교와 하이브리드 검색(BM25 + Dense) 구축
- 2-2. Cross-Encoder 리랭킹(Reranking)을 통한 검색 정확도 극대화
토픽 3: LlamaIndex 고급 쿼리 엔진 및 Ragas 성능 평가
- 3-1. LlamaIndex Sub-Question Query Engine으로 복합 질의 해결
- 3-2. Ragas 기반 RAG 삼각편대(RAG Triad) 정량 평가 및 프로덕션 배포
필수 조건
- 파이썬(Python) 기본 문법 및 가상환경(venv/conda) 사용 경험
- OpenAI 또는 Anthropic API 발급 및 기초 호출 경험
- 기본적인 자료구조 및 벡터/임베딩에 대한 기초적인 관심
수강 대상
- 사내 지식베이스나 기술 문서를 연결한 고성능 AI 질의응답 챗봇을 구현하려는 개발자
- 단순 프롬프트 호출의 한계를 극복하고 최신 RAG 아키텍처를 도입하려는 AI 엔지니어
- 엔터프라이즈 AI 서비스 기획 및 데이터 아키텍처를 검토 중인 테크 리더 및 PM