Vector DB(벡터 데이터베이스) 실전: Milvus & Pinecone 대용량 임베딩 인덱싱
강좌 소개
LLM 및 멀티모달 AI의 필수 스토리지 계층으로 급부상한 벡터 데이터베이스(Vector Database)의 내부 원리와 대규모 프로덕션 운영 노하우를 다룹니다.
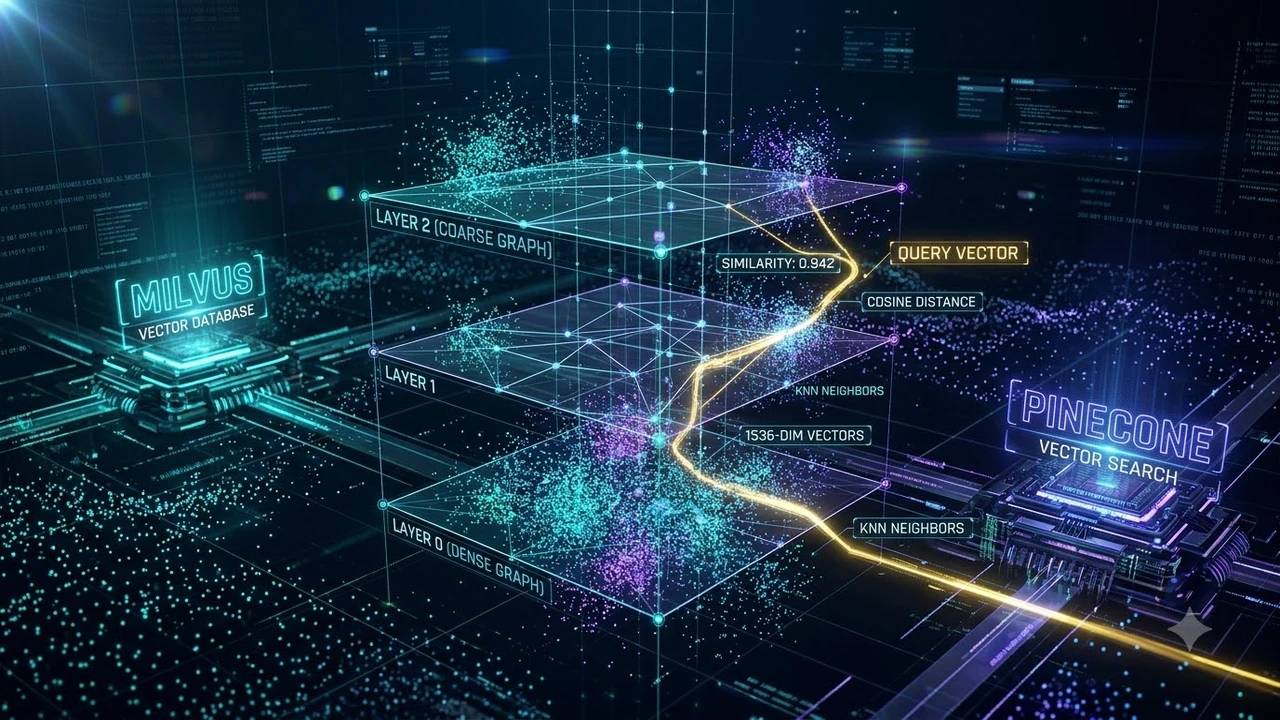
근사 최근접 이웃(ANN: Approximate Nearest Neighbor) 검색 알고리즘인 HNSW(Hierarchical Navigable Small World)와 IVF-Flat의 수학적 원리를 이해하고, 오픈소스 대용량 벡터 DB인 Milvus와 완전관리형 Pinecone을 활용해 수백만 건의 임베딩을 밀리초(ms) 단위로 검색하는 파이프라인을 완성합니다.
이 강좌에서 배우는 것들
- 고차원 벡터 공간에서의 거리 척도(유클리드, 코사인, 내적) 이해
- HNSW, IVF 등 핵심 ANN 인덱싱 알고리즘의 동작 메커니즘 분석
- Milvus 클러스터 배포 및 메타데이터 필터링 하이브리드 인덱싱
- 수백만 건의 텍스트/이미지 임베딩 고속 시맨틱 검색 엔진 구축
교육 과정 (Curriculum)
Section 1: 벡터 검색의 원리와 ANN 알고리즘
- 왜 전통적 인덱스(B-Tree)로는 벡터 검색이 불가능한가?
- 차원의 저주와 정확한 최근접 이웃(KNN)의 한계
- HNSW(계층형 탐색 가능 소규모 세상) 그래프 알고리즘의 수학적 직관
Section 2: Pinecone 완전관리형 벡터 클러스터 활용
- Pinecone 인덱스 생성과 차원(Dimension), 메트릭 설정
- 네임스페이스(Namespace)와 메타데이터 필터링 쿼리
- 배치 업서트(Batch Upsert)를 통한 대규모 임베딩 고속 색인
Section 3: 오픈소스 Milvus 분산 배포와 튜닝
- Milvus 아키텍처: Coordinator, Worker, MinIO 스토리지 분리
- 컬렉션 스키마 정의 및 HNSW 파라미터(M, efConstruction) 튜닝
- 하이브리드 검색(단어 검색 + 벡터 유사도)과 재순위화 프로덕션 배포
필수 조건
- 파이썬 중급 및 벡터/임베딩 기본 개념
수강 대상
- 대규모 RAG 또는 시맨틱 검색 엔진을 구축하려는 AI 인프라 엔지니어
- 일반 관계형 DB의 벡터 확장(pgvector) 한계를 넘어선 전용 DB를 찾는 개발자
- 최신 벡터 데이터베이스의 성능 튜닝과 인덱싱을 연구하려는 학습자